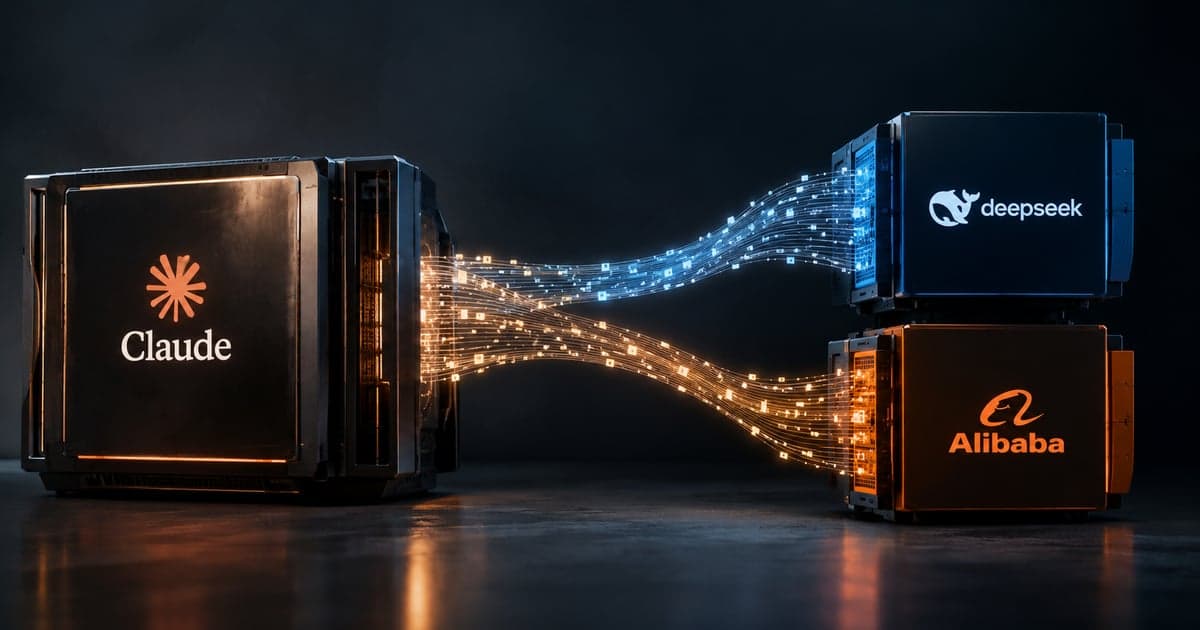
Pe 10 septembrie, Anthropic a publicat un raport în care acuză mai multe laboratoare AI din China că i-au extras sistematic capabilitățile lui Claude ca să-și antreneze propriile modele — aproximativ 190 de milioane de schimburi de mesaje. Cearta dintre companii e mai puțin interesantă decât un detaliu îngropat în raport: unii dintre acei oameni care trimiteau mesaje nu erau spioni industriali, ci clienți obișnuiți ai unui chatbot chinezesc, care nu știau că vorbesc de fapt cu Claude.
Ce înseamnă distilare, sau knowledge distillation
Distilarea cunoștințelor e o tehnică veche și perfect legitimă în machine learning. Iei un model mare și scump (numit „profesor"), îl pui să răspundă la foarte multe întrebări, apoi antrenezi un model mai mic („elev") pe răspunsurile lui. Modelul mic nu învață din date brute, ci din raționamentul deja digerat al celui mare. Iese mai ieftin de rulat și, cu puțin noroc, aproape la fel de bun.
Toată industria face asta. Diferența dintre legitim și ceea ce Anthropic numește distilare ilicită e simplă: profesorul e modelul altcuiva, comercial, iar extragerea se face împotriva termenilor de utilizare, prin conturi false.
Ce se urmărea concret nu era textul răspunsurilor, ci lanțul de raționament — pașii interni prin care modelul ajunge la un răspuns. Aia e partea scumpă. Dacă vrei să înțelegi de ce, articolul despre cum funcționează ChatGPT și modelele de limbaj explică ce se întâmplă între întrebare și răspuns.
Cifrele din raport
| Laborator | Schimburi | Perioadă |
|---|---|---|
| Alibaba | ~151 milioane | mai – iulie 2026, ~3.500 de conturi |
| Moonshot (Kimi) | ~23 milioane | mai – iulie 2026 |
| DeepSeek | peste 12 milioane | 14 zile, iulie 2026 |
| Zhipu | ~3,4 milioane | 17 zile, iunie – iulie 2026 |
| Xiaomi | ~400.000 | 20 de zile, martie – aprilie 2026 |
Campania Alibaba e, spune Anthropic, cea mai mare pe care a documentat-o vreodată: a atins vârfuri de aproape 3 milioane de interacțiuni pe zi, iar materialul obținut ar fi ajuns în antrenamentul familiei de modele Qwen. Una dintre metodele de ocolire a protecțiilor a fost deghizarea cererilor în sarcini de traducere.
Partea care te privește direct
Aici raportul devine relevant pentru oricine folosește un asistent AI, nu doar pentru laboratoare.
Anthropic susține că Moonshot a redirecționat pe ascuns cereri ale propriilor clienți către Claude și a afișat răspunsurile ca fiind ale lui Kimi. Aproape 300.000 de cereri într-un interval de zece zile, prin peste 5.000 de conturi false. DeepSeek ar fi procedat similar, fără să-și anunțe utilizatorii.
Gândește-te ce înseamnă asta practic. Scrii ceva într-un chatbot — poate un contract, poate o problemă medicală, poate cod din firma ta. Crezi că datele ajung la compania al cărei produs îl folosești, sub politica ei de confidențialitate. În realitate, textul tău pleacă la un al treilea furnizor, despre care nu ți-a spus nimeni. Nu ai cum să afli, nu ai cum să refuzi și nu apare în nicio politică de confidențialitate pe care ai acceptat-o.
Tot din raport, un detaliu greu de trecut cu vederea: printre cererile relatate de Moonshot către Claude, Anthropic descrie și solicitări care păreau să vină din zona militară chineză, inclusiv una de analizare a unor imagini de supraveghere.
Anthropic a închis conturile implicate și a schimbat modul în care Claude expune raționamentul intern — acum îl rezumă înainte de a răspunde, tocmai ca să fie mai greu de recoltat.
Ce spune cealaltă parte
Companiile numite nu au reacționat public în primele zile — raportul a apărut într-un interval nelucrător în China. E corect să spun asta, ca să nu citești un text cu o singură voce.
Merită știut și că Anthropic nu e singură în asta. Cu o zi înainte de raport, pe 8 septembrie, NSA, CISA și FBI au emis o notificare comună de securitate cibernetică în care acuzau companii AI chinezești — printre care DeepSeek, Moonshot, Alibaba, MiniMax, StepFun și Z.AI — că extrag sistematic capabilități din modelele americane de vârf: Claude, GPT, Gemini și Grok.
Guvernul chinez a răspuns pe 9 septembrie. Ministerul Comerțului a numit acuzațiile nefondate și lipsite de temei juridic, a spus că Statele Unite politizează o chestiune tehnică și comercială normală și că urmăresc „hegemonie tehnologică" și monopol asupra puterii de calcul. A subliniat, de asemenea, că distilarea e o practică obișnuită în domeniu.
Punctul acela nu e o simplă replică de propagandă — e parțial adevărat, și de-aia subiectul e complicat. Toate laboratoarele mari s-au antrenat pe text scris de alții, de multe ori fără permisiune. OpenAI însăși a acuzat DeepSeek de distilare încă de anul trecut, în timp ce se apăra în procese privind datele pe care s-a antrenat. Deocamdată, distilarea neautorizată e în primul rând o încălcare a termenilor de utilizare, nu o ilegalitate stabilită de vreo instanță.
Ce schimbă asta pentru tine
Trei lucruri concrete, în ordinea importanței.
Acuzația de „furt de model" nu te privește. E o dispută comercială între laboratoare, se va rezolva în contracte și procese, și nu schimbă cu nimic dacă un model e bun sau prost pentru munca ta. Nu schimba uneltele din indignare.
Redirecționarea cererilor te privește foarte mult. Asta nu e o chestiune de proprietate intelectuală, ci de confidențialitate. Dacă trimiți date de lucru într-un chatbot — ale tale sau ale clienților tăi — miza nu mai e teoretică. Pentru datele sensibile, regula rămâne cea plictisitoare și corectă: nu le pui într-un serviciu gratuit sau ieftin a cărui infrastructură nu o poți verifica.
Modelele deschise arată acum mai bine, nu mai rău. Sună contraintuitiv, dar exact aici e diferența practică: un model cu greutăți publicate, pe care îl rulezi pe infrastructura ta, nu poate redirecționa nimic către nimeni, pentru că nu are unde. Ieri am scris despre DeepSeek V4.1 Flash și ce înseamnă open weights — raportul ăsta întărește argumentul pentru rularea locală și îl slăbește pe cel pentru API-ul lor.
Părerea mea, asumat: partea de distilare o să se stingă în comunicate și avocați. Partea cu clienții redirecționați fără să știe ar trebui să rămână, pentru că e singurul lucru din tot raportul care schimbă ce ar trebui să facă un utilizator obișnuit luni dimineață.
Întrebări frecvente
Ce este knowledge distillation?
Metoda prin care un model nou învață din răspunsurile altui model, în loc să învețe direct din date brute. Modelul mare e „profesorul", cel mic „elevul". E o tehnică legitimă și folosită pe scară largă; problema apare când profesorul e un model al altcuiva, folosit fără permisiune.
De ce e problematică distilarea din modelele comerciale?
Pentru că termenii de utilizare ai majorității furnizorilor interzic explicit folosirea rezultatelor pentru antrenarea unui model concurent. Acuzația nu e de furt de cod, ci de încălcare a contractului de utilizare.
Cum afectează asta pe cineva care doar folosește modelele?
Direct, aproape deloc. Indirect, contează: dacă distilarea devine imposibilă, modelele ieftine dispar sau se scumpesc, iar diferența de preț dintre furnizori se micșorează în defavoarea ta.
Dacă ai ajuns aici fără să știi ce e produsul despre care se ceartă toată lumea, am scris separat despre Claude AI: ce face, cât costă și unde se oprește.