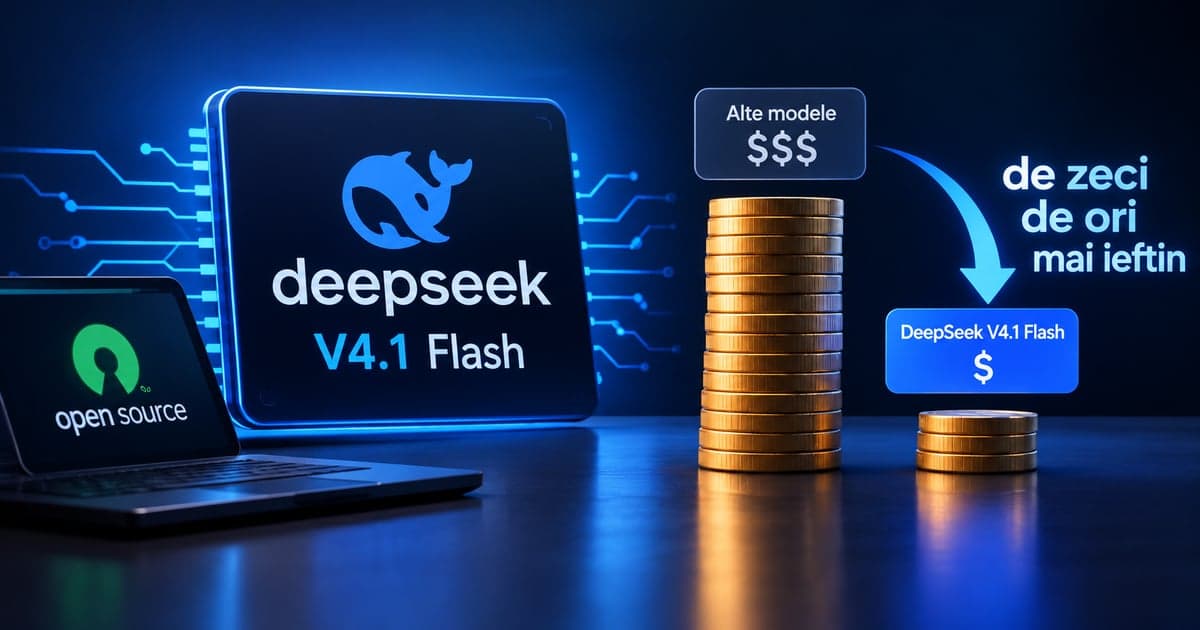
Pe 10 septembrie, DeepSeek a publicat V4.1 Flash cu greutățile deschise pe Hugging Face, sub licență MIT. Pe Terminal-Bench 2.1 obține 90,6 puncte, față de 89,1 la Claude Opus 5 și 88,8 la GPT-5.6 Sol. Prin DeepSeek API costă 15 cenți pe milion de tokeni de intrare — modelele cu care se compară costă 10 dolari.
Actualizare, 12 septembrie 2026
Două lucruri s-au schimbat la o zi după publicarea articolului, și amândouă ating recomandările de mai jos.
Anthropic acuză DeepSeek de distilare ilicită. Un raport publicat pe 10 septembrie susține că DeepSeek a extras peste 12 milioane de schimburi din Claude într-un interval de 14 zile din iulie, ca să-și antreneze modelele — și, mai important pentru tine, că ar fi redirecționat cereri ale propriilor clienți către Claude fără să-i anunțe. Compania nu a reacționat public. Detaliile, cu tot cu replica părții chineze, sunt în articolul despre acuzațiile Anthropic.
Hugging Face trece la Nvidia. Pe 3 septembrie, Nvidia a anunțat achiziția platformei pentru 12,93 miliarde de dolari, tranzacție care se închide după avizele autorităților de concurență. Nvidia promite că platforma rămâne deschisă pentru tot ecosistemul. Nu se schimbă nimic azi la licența MIT a modelului, dar locul unde stau greutățile deschise ale lumii nu mai e o companie independentă.
Concluzia articolului rămâne. Dacă ceva, argumentul pentru rularea pe infrastructură proprie e mai puternic decât era ieri. Ce se schimbă e recomandarea pentru API-ul DeepSeek: până când compania răspunde la acuzații, n-aș trimite acolo date de lucru sau date ale clienților.
Ce spun cifrele, și cât costă prin DeepSeek API
Pe testele agentice, unde modelul trebuie să ducă la capăt o sarcină lungă folosind unelte, V4.1 Flash întrece GPT-5.6 Sol pe patru din cele cinci benchmark-uri grele:
| Test | V4.1 Flash | GPT-5.6 Sol |
|---|---|---|
| DeepSWE v1.1 (inginerie software) | 74,2 | 73,0 |
| AutomationBench | 54,8 | 45,8 |
| Agent's Last Exam | 31,8 | 26,7 |
| CyberGym | 88,1 | 84,5 |
Există o precizare importantă, pe care DeepSeek o face și care se pierde în relatări: scorurile sunt obținute la efort de raționament maxim. Adică modelul consumă mult mai mulți tokeni decât în folosirea obișnuită. Avantajul de preț rămâne considerabil, dar nu e chiar raportul brut de la prima vedere.
Prețul de listă: 15 cenți intrare (necache-uit) și 60 de cenți ieșire, per milion de tokeni, în afara orelor de vârf. În intervalele aglomerate din timpul săptămânii se dublează. Față de V4-Pro, modelul de vârf anterior al companiei, e cu circa 70% mai ieftin.
DeepSeek API: de ce e atât de ieftin
Prețul prin DeepSeek API e ce a produs valul de atenție, iar explicația e arhitecturală, nu comercială. V4.1 Flash are 552 de miliarde de parametri, dar folosește o arhitectură mixture-of-experts: din toată masa aia, doar 8 miliarde de parametri sunt activi cât timp modelul citește promptul și 16 miliarde cât timp generează răspunsul.
Peste asta, DeepSeek a schimbat forma rețelei într-un design numit causal encoder-decoder: 40 de straturi, organizate ca 20 de straturi de encoder cauzal urmate de 20 de decoder. Și a comprimat memoria de context — cache-ul de chei și valori — la virgulă mobilă pe patru biți, ajungând la aproximativ 890 de bytes per token, cam un sfert din cât ocupa generația anterioară.
Traducerea în limbaj obișnuit: modelul e uriaș ca bagaj de cunoștințe, dar ieftin la fiecare cuvânt produs, pentru că nu își pune la treabă decât o felie mică din el odată. Dacă vrei să înțelegi de ce contextul și tokenii sunt atât de scumpi în primul rând, am explicat mecanismul în tokeni, embeddings și context.
De ce DeepSeek API, și nu pe serverul tău
Aici trebuie făcută o corecție pe care aproape nimeni nu o face.
În primul rând, corect e open weights, nu open source: DeepSeek publică greutățile modelului sub licență MIT, cu documentație de rulare, dar nu publică datele de antrenament. Poți folosi, modifica și redistribui modelul; nu poți reconstrui procesul care l-a produs.
În al doilea rând — și e partea care dezamăgește lumea — faptul că doar 8 miliarde de parametri sunt activi nu înseamnă că ai nevoie de memorie pentru 8 miliarde. Toți cei 552 de miliarde trebuie să fie disponibili, pentru că nu știi dinainte ce „experți" va alege modelul la fiecare token. Fișierele sunt împărțite în 48 de bucăți pe Hugging Face, fără restricții de acces, și nu încap pe niciun calculator personal. Există variante comprimate făcute de comunitate, dar cu pierdere de calitate.
Deci ce cumperi, de fapt, cu o licență MIT? Trei lucruri concrete: dreptul de a rula modelul pe infrastructura ta sau a altui furnizor, fără să depinzi de un singur vânzător; posibilitatea de a fi auditat de altcineva decât cel care l-a făcut; și garanția că modelul nu dispare peste noapte dintr-un API, așa cum se întâmplă constant cu versiunile comerciale.
Cum folosești DeepSeek API: preț și primii pași
Partea bună e că nu trebuie să înveți nimic nou. Documentația oficială spune explicit că DeepSeek API folosește un format compatibil cu OpenAI și Anthropic — adică biblioteca pe care o ai deja merge, îi schimbi doar adresa și cheia.
Trei lucruri de știut înainte să pornești:
- Adresa:
https://api.deepseek.com - Numele modelelor:
deepseek-flashșideepseek-v4-pro - Cheia se ia din panoul de pe
platform.deepseek.com, secțiunea de chei API
Grila oficială, per milion de tokeni, pentru deepseek-flash:
| Intrare, necache-uit | Intrare, din cache | Ieșire | |
|---|---|---|---|
| tarif redus | 0,15 $ | 0,003 $ | 0,60 $ |
| tarif de vârf | 0,30 $ | 0,006 $ | 1,20 $ |
Două lucruri care se pierd ușor din tabelul ăsta. Întâi, tariful redus e jumătate din cel de vârf, iar ferestrele sunt definite în ora UTC, nu în ora României — dacă rulezi lucruri în loturi care pot aștepta, programarea lor în afara vârfului înjumătățește factura fără nicio altă modificare.
Al doilea, citirea din cache e de cincizeci de ori mai ieftină decât intrarea normală. Dacă trimiți același context lung la fiecare apel — un prompt de sistem, o documentație, un set de exemple — diferența dintre a folosi cache-ul și a nu-l folosi e mai mare decât diferența dintre DeepSeek și oricare concurent.
API DeepSeek: pentru cine contează
Contează dacă rulezi volume mari și repetitive prin API — clasificare, extragere de date, procesare de documente, agenți care fac aceeași sarcină de mii de ori. Acolo diferența dintre 15 cenți și 10 dolari pe milion de tokeni nu e o optimizare, e diferența dintre un proiect viabil și unul care nu se face.
Nu contează dacă folosești un asistent AI prin abonament, pentru scris și întrebări. DeepSeek are aplicație web și mobilă cu V4.1 Flash inclus, dar dacă ești mulțumit de ChatGPT sau Claude nu ai niciun motiv practic să te muți — cu mențiunea, deloc neînsemnată, că DeepSeek e o companie chinezească și datele tale ajung sub altă jurisdicție decât cea europeană.
Părerea mea: septembrie 2026 e luna în care ipoteza „modelele deschise sunt cu un an în urmă" a încetat să fie adevărată. Nu pentru că V4.1 Flash e cel mai bun model din lume — nu e — ci pentru că diferența față de vârf a scăzut sub pragul la care majoritatea oamenilor o pot observa, în timp ce diferența de preț a rămas de două ordine de mărime.
Dacă vrei contextul complet al lunii, am scris separat despre cele patru modele lansate într-o singură săptămână, iar pentru fundamente, despre cum funcționează ChatGPT și LLM-urile.
Întrebări frecvente
Cât costă DeepSeek API?
Pentru modelul deepseek-flash, grila oficială e de 0,15 $ intrare necache-uită și 0,60 $ ieșire per milion de tokeni la tarif redus; în orele de vârf se dublează, la 0,30 $ și 1,20 $. Citirea din cache costă 0,003 $, adică de cincizeci de ori mai puțin decât intrarea normală.
Cum încep să folosesc DeepSeek API?
Documentația oficială spune că formatul e compatibil cu OpenAI și Anthropic, deci biblioteca pe care o ai deja merge — îi schimbi doar adresa, api.deepseek.com, și cheia, luată din panoul de pe platform.deepseek.com. Numele modelelor sunt deepseek-flash și deepseek-v4-pro.
Pot rula DeepSeek V4.1 Flash pe calculatorul meu?
Nu. Faptul că doar 8 miliarde de parametri sunt activi nu înseamnă că ai nevoie de memorie pentru 8 miliarde: toți cei 552 de miliarde trebuie să fie disponibili, pentru că nu se știe dinainte ce experți alege modelul la fiecare token. Fișierele sunt împărțite în 48 de bucăți pe Hugging Face și nu încap pe niciun calculator personal. Există variante comprimate făcute de comunitate, dar cu pierdere de calitate.
DeepSeek V4.1 Flash e open source?
Corect e open weights, nu open source. DeepSeek publică greutățile sub licență MIT, cu documentație de rulare, dar nu publică datele de antrenament. Poți folosi, modifica și redistribui modelul; nu poți reconstrui procesul care l-a produs.
E sigur să trimit date de lucru către DeepSeek API?
Pe 10 septembrie 2026, Anthropic a publicat un raport în care susține că DeepSeek ar fi redirecționat cereri ale propriilor clienți către Claude fără să-i anunțe. Compania nu a reacționat public. Până la un răspuns, recomandarea din articol e să nu trimiți acolo date de lucru sau date ale clienților — argumentul pentru rularea pe infrastructură proprie rămâne valabil.