Un studiu publicat pe 10 martie 2026 a testat nouă detectoare de text generat cu AI. Pe text curat, cele comerciale se descurcă bine — Copyleaks și Originality.ai au avut rate aproape perfecte. Dar când același text a fost rescris în stilul unui vorbitor non-nativ de engleză, Turnitin a scăzut la 45,7% acuratețe, iar Grammarly la 19%.
Sub jumătate. Adică, în acel scenariu, o monedă aruncată e la fel de bună. Iar dacă te întrebi cât de bine merge un detector AI română, răspunsul e că nimeni nu a măsurat.
Verificare text AI: ce s-a testat, concret
Studiul a verificat nouă unelte — Turnitin, ZeroGPT, Detecting-AI, GPTZero, QuillBot, Grammarly, Sapling, Copyleaks și Originality.ai — pe texte generate cu patru modele: ChatGPT, DeepSeek, Gemini și Grok.
Rezultatele inițiale au fost bune pentru soluțiile plătite și slabe pentru cele gratuite: Grammarly și QuillBot au coborât până la 63%.
Apoi au aplicat tehnici de mascare: parafrazare și rescriere în stil non-nativ. Aici s-a rupt totul, dar nu uniform. Copyleaks, GPTZero și Sapling au rezistat. Turnitin — cel mai folosit în educație — a căzut la 45,7%.
De ce contează fix acest tip de mascare
Pentru că nu e o tehnică de fraudă. E felul în care scrie, natural, jumătate din planetă.
Detectoarele caută text previzibil: structură regulată, vocabular comun, puține abateri idiomatice. Exact cum scrie cineva într-o limbă pe care o stăpânește funcțional, dar nu nativ — fraze mai scurte, construcții mai sigure, mai puține expresii. Acelea sunt și semnăturile statistice ale unui model de limbaj.
Dacă vrei să înțelegi mecanismul, am explicat separat cum funcționează modelele de limbaj și de unde vine previzibilitatea textului.
Rezultatul e o eroare care merge în ambele direcții:
- Text AI rescris în acel stil trece nedetectat — exact cazul în care cineva chiar a vrut să ascundă ceva.
- Text uman scris în acel stil e marcat greșit — exact cazul în care nimeni n-a ascuns nimic.
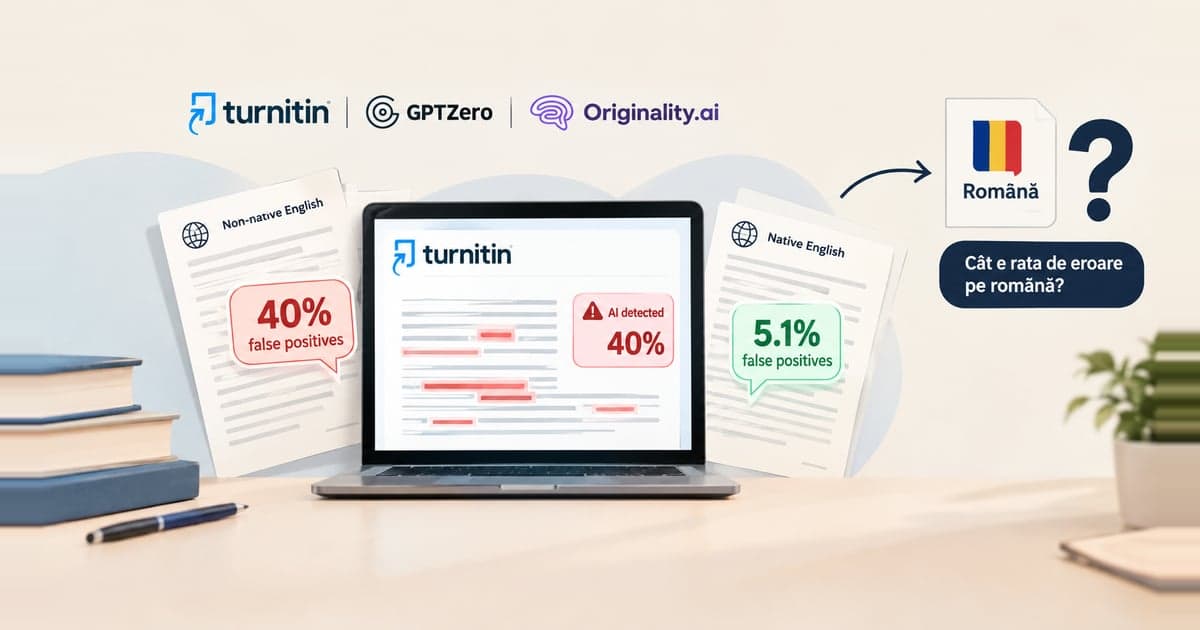
A doua direcție are cifre separate, și sunt mai vechi: testat pe eseuri TOEFL, Turnitin a marcat greșit până la 40% din lucrările studenților non-nativi, față de 5,1% la vorbitorii nativi. De opt ori mai multe acuzații false, pentru aceiași oameni care oricum scriu într-o limbă împrumutată.
Cine mai e prins de un detector de AI
Aceeași mecanică lovește și pe cei cu scriere structurată, repetitivă sau foarte literală, inclusiv persoane neurodivergente. Un text ordonat, cu propoziții de lungime similară și fără digresiuni, arată la fel indiferent dacă îl produce un model sau un copil căruia i s-a spus toată viața să scrie ordonat.
Nu e o problemă de intenție. E o problemă de ce anume măsoară un detector AI: nu cine a scris textul, ci cât de previzibil e.
Detector AI română: întrebarea pe care n-o pune nimeni
Toate studiile astea măsoară engleza. Nu există niciun detector AI română testat public.
N-am găsit nicio cercetare publicată care să dea rata de eroare a detectoarelor pe texte în limba română. Nici producătorii n-o publică. Uneltele sunt antrenate preponderent pe corpusuri englezești, iar româna e, în datele lor, o limbă cu resurse puține.
Ce știm din datele existente e că eroarea crește pe măsură ce textul se îndepărtează de engleza nativă. Cât crește pe română? Nimeni nu poate spune, pentru că nimeni n-a măsurat.
Între timp, servicii precum plag.ro sau aidetector.ro oferă câte un detector AI pentru texte românești,
iar profesori din România încep să le folosească. Verificarea se face cu un instrument a cărui rată
de eroare pe limba textului verificat e, literalmente, necunoscută.
Detector text AI: ce faci practic
Dacă ești profesor: alege unealta după datele de rezistență la mascare, nu după preț sau notorietate — diferența dintre 45,7% și „a rezistat" e uriașă. Și tratează rezultatul ca pe un indiciu, nu ca pe o probă. Un scor de 85% nu înseamnă 85% certitudine; înseamnă că textul are proprietăți statistice pe care instrumentul le asociază cu generarea automată. Conversația cu elevul despre ce a scris rămâne singura metodă care nu produce victime colaterale.
Dacă ești elev sau student acuzat: cere rezultatul complet, nu procentul. Întreabă ce instrument s-a folosit și ce rată de eroare are pe română. Faptul că nu există un răspuns e, în sine, informația relevantă.
Dacă ești instituție care cumpără așa ceva: cere furnizorului datele de validare pe română. Absența lor spune tot.
Părerea mea, după ce am citit cifrele: problema nu e că detectoarele greșesc — orice instrument statistic greșește. Problema e că sunt vândute și folosite ca și cum n-ar greși, iar costul erorilor cade pe cei care au cel mai puțin de spus în discuție. Un elev acuzat pe baza unui procent nu are cum să demonstreze că a scris singur.
Pentru contextul mai larg despre ce poate și ce nu poate face procesarea automată a limbajului, pornește de la ce este NLP.
Întrebări frecvente
Cât de precis e un detector AI?
Pe text curat, uneltele comerciale bune sunt aproape perfecte. Pe text rescris în stil non-nativ, Turnitin a coborât la 45,7% și Grammarly la 19% în studiul din martie 2026. Sub jumătate înseamnă mai prost decât o monedă aruncată.
Cum verific dacă un text e scris cu AI?
Pe scurt: nu poți, cu certitudine. Detectoarele dau un scor de probabilitate, nu un verdict, iar pe texte scrise de vorbitori non-nativi greșesc sistematic în defavoarea lor. Dacă tot le folosești, tratează rezultatul ca pe un indiciu care cere verificare umană — istoricul documentului, ciornele, întrebări despre conținut — niciodată ca pe o dovadă.
Există un detector AI pentru română?
Există servicii care oferă detectare text AI pe română, dar niciunul nu publică rata de eroare pe limba română, și nu am găsit nicio cercetare independentă care s-o măsoare. Verificarea se face cu un instrument a cărui precizie pe limba verificată e necunoscută.
Ce fac dacă sunt acuzat pe baza unui detector de AI?
Cere rezultatul complet, nu procentul. Întreabă ce instrument s-a folosit și ce rată de eroare are pe română. Faptul că nu există un răspuns e, în sine, informația relevantă.