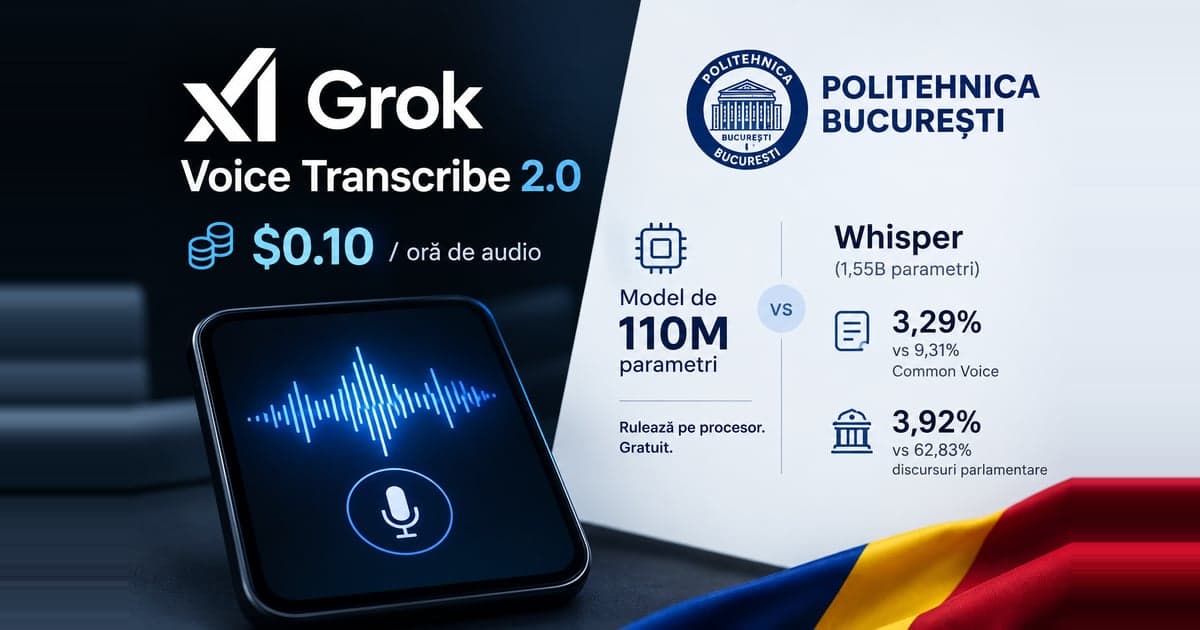
Dacă ai căutat vreodată un serviciu de transcriere audio în text care să se descurce pe română, știi că prețul n-a fost niciodată problema. Pe 18 septembrie, xAI a lansat un model care costă 10 cenți ora de audio și stă pe primul loc din 32 la acuratețe în streaming. Cifra care contează pentru tine e însă alta, și vine dintr-o lucrare scrisă la Politehnica București: 3,29%.
Ce s-a lansat: modelul de transcriere xAI
Grok Voice Transcribe 2.0 costă 0,10 $ pe oră de audio în procesare normală și 0,20 $ în streaming. În preț intră lucruri care de obicei se plătesc separat: identificarea vorbitorilor, timestamp-uri la nivel de cuvânt cu scor de încredere, transcriere pe până la 8 canale, eliminarea ezitărilor și formatarea automată a cifrelor, datelor și numerelor de telefon.
xAI raportează o singură cifră concretă de acuratețe: pe un set de fraze scurte în 19 limbi, rata de eroare pe cuvânt a scăzut de la 20,6% la 6,8%. Restul comparațiilor sunt prezentate ca grafice, fără valori. Modelul e primul din 32 pe clasamentul Artificial Analysis pentru streaming.
Două lucruri de reținut înainte să te entuziasmezi. Cifrele sunt raportate de producător și nu au fost reproduse independent. Și modelul e disponibil doar prin API — nu există greutăți deschise, deci nu-l poți rula la tine.
Cât costă transcrierea audio, comparativ
| Serviciu | Preț pe oră de audio |
|---|---|
| Grok Voice Transcribe 2.0 (batch) | 0,10 $ |
| Grok Voice Transcribe 2.0 (streaming) | 0,20 $ |
OpenAI gpt-4o-mini-transcribe | 0,18 $ |
OpenAI gpt-transcribe | 0,27 $ |
OpenAI gpt-4o-transcribe / Whisper | 0,36 $ |
Deci un interviu de o oră se transcrie cu mai puțin de jumătate de leu, la oricare dintre ele. Diferențele de preț dintre furnizori au devenit neinteresante — la volumele la care lucrează un om normal, alegi după altceva.
Actualizare: Alibaba a tăiat prețul cu până la 95%
Pe 23 septembrie, trei zile după ce am publicat articolul ăsta, Alibaba a lansat Qwen-Audio-3.1 — cinci modele de voce — și a anunțat reduceri de preț mari: până la 95% la recunoașterea vorbirii, circa 85% la vocea în timp real și circa 70% la sinteza vocală.
Două dintre cele cinci sunt noi. Cel care contează pentru transcriere e ASR-Next, și face lucruri care până acum se plăteau separat sau nu existau: identifică vorbitorii cu etichete și timestamp-uri aliniate la text, și în plus recunoaște emoții, zgomote de fundal și sunete de utilaje, ca să poată descrie ce se aude, nu doar ce se spune. Modelul ASR de bază a primit recunoaștere mai bună pe limbi și dialecte, plus curățarea automată a ezitărilor și a repetițiilor.
De ce nu apare în tabelul de mai sus: pentru că Alibaba a anunțat procente, nu prețuri. Nici în comunicat, nici în presa care l-a preluat nu există o cifră absolută pe oră de audio, și nici data de la care intră în vigoare tarifele noi. Un „minus 95%" fără punctul de plecare nu se poate compara cu 0,10 $ pe oră de la Grok. Rămâne de completat când publică grila.
Partea din lansarea asta care chiar schimbă ceva pentru română o iau mai jos, după cifrele reale — are sens doar cu ele pe masă.
Dar speech to text română?
Aici se oprește toată lăudăroșenia, și merită spus limpede: nimeni nu publică cifre pentru română.
xAI spune „zeci de limbi" și formatare pentru 25, fără să le numească. Setul multilingv pe care raportează îmbunătățirea acoperă 19 limbi, tot nenumite. Clasamentul Artificial Analysis pe care e primul se calculează din trei componente — AgentTalk, VoxPopuli și Earnings22 — și niciuna nu e o măsurătoare de română.
Nu spun că merge prost. Spun că nu știi, iar cine îți vinde certitudinea o inventează.
Speech to text în română: cifrele reale
Există măsurători serioase pe română, doar că nu vin de la laboratoarele mari. În noiembrie 2025, trei cercetători de la laboratorul Speech and Dialogue de la Politehnica București — Gabriel Pîrlogeanu, Alexandru-Lucian Georgescu și Horia Cucu — au publicat un model antrenat pe peste 2.600 de ore de vorbire în română și l-au testat pe șapte seturi de evaluare românești.
Modelul lor, Parakeet Ro, are 110 milioane de parametri. L-au comparat cu RoWhisper-large-v2, adică Whisper ajustat pe română, care are 1,55 miliarde — de paisprezece ori mai mare.
Rata de eroare pe cuvânt, cu cât mai mică cu atât mai bine:
| Set de test | Parakeet Ro (110M) | RoWhisper-large-v2 (1,55B) |
|---|---|---|
| Common Voice 21 română | 3,29% | 9,31% |
| Vorbire citită (RSC) | 1,73% | 3,09% |
| Vorbire spontană (SSC-eval2) | 10,75% | 61,46% |
| Discurs public, Camera Deputaților | 3,92% | 62,83% |
| FLEURS română | 8,85% | — |
Pe vorbire citită diferența e mică. Pe vorbire spontană — adică oameni care se întrerup, se răzgândesc și vorbesc unul peste altul — modelul mare se prăbușește: 61% eroare înseamnă că mai mult de jumătate din cuvinte ies greșit. Pe discursurile din Camera Deputaților, 62,83% față de 3,92%. Nu e o diferență procentuală, e diferența dintre folosibil și inutil.
Și mai există un număr care contează practic: modelul rulează de circa 109 ori mai repede decât timpul real, fără placă video — măsurat pe un procesor desktop cu 24 de nuclee. Un interviu de o oră se transcrie în vreo treizeci de secunde. Codul și modelul sunt publicate public, iar cercetarea a fost finanțată din proiectul european AI4TRUST și dintr-un grant al Ministerului Cercetării.
O precizare corectă: lucrarea compară cu Whisper ajustat pe română și cu un sistem clasic
Kaldi. Nu a testat gpt-4o-transcribe sau modelul xAI de săptămâna asta. Deci nu putem spune
„bate tot" — putem spune că, pe română, un model mic și specializat bate unul de paisprezece ori
mai mare și generalist.
Unde intră Qwen3-ASR pe lista asta
Cu cifrele de mai sus pe masă, se vede ce lipsește din lansarea Alibaba. Separat de API, compania are și modele deschise: Qwen3-ASR, în variante de 1,7 și 0,6 miliarde de parametri, licență Apache 2.0. Lista lor oficială are 30 de limbi, iar româna e una din ele — alături de maghiară, poloneză, cehă, greacă și macedoneană.
E primul furnizor mare din articolul ăsta care scrie negru pe alb „română", și merită notat. Dar păstrează scepticismul: tot nu există o cifră de acuratețe pe română. Singurele rate de eroare publicate sunt pe engleză, pe Librispeech — 1,63% pe setul curat și 3,38% pe cel greu. Iar tabelul de mai sus arată exact de ce asta nu ajunge: RoWhisper trece de la 3,09% pe vorbire citită la 61,46% pe vorbire spontană. Un număr pe engleză curată nu-ți spune nimic despre o ședință în română.
Deci Qwen3-ASR intră pe lista de testat lângă modelul de la Politehnică, nu peste el. Sunt ambele gratuite și ambele rulează la tine — nu ai scuză să nu le compari pe propriul audio.
De ce merge speech to text română mai prost
Pentru că datele contează mai mult decât dimensiunea, iar asta e o temă care se repetă peste tot în AI acum.
Whisper a fost antrenat pe un corpus uriaș, multilingv, în care româna e o firimitură. Știe română „literară", cum arată ea în texte curate. Când aude un om care vorbește normal, cu ezitări și regionalisme, nu mai are pe ce să se sprijine. Modelul de la Politehnică a văzut 2.600 de ore de română reală, inclusiv ședințe de parlament și vorbire spontană — și exact acolo câștigă.
E aceeași logică din spatele explicației despre cum funcționează modelele de limbaj: un model nu poate fi mai bun decât ce a văzut.
Ce program de transcriere audio în text alegi
Transcrii ocazional un interviu sau un curs. Folosește ce ai deja. Google Docs are dictare în română, gratuit. Pentru fișiere, orice unealtă construită peste Whisper îți dă un rezultat decent pe vorbire clară.
Ai volum și ești tehnic. Modelul de la Politehnica București, rulat local. E gratuit, merge pe procesor, iar pe română are cele mai bune cifre publicate. Dacă transcrii zeci de ore pe lună, diferența față de API se simte. Din 23 septembrie mai ai și Qwen3-ASR ca al doilea candidat deschis, care listează româna oficial — dar fără cifre pe română, deci verifică-l tu.
Îți trebuie identificarea vorbitorilor și timestamp-uri fără să administrezi nimic. API, și aici Grok e cel mai ieftin la 0,10 $ ora. Dar testează-l pe o oră din propriul tău audio înainte să-ți muți fluxul pe el — n-ai cum să știi altfel cum se descurcă pe română.
Transcrii ședințe cu mai mulți vorbitori care se întrerup. Ăsta e cazul cel mai greu, și fix acolo se rupe totul. Testează obligatoriu, indiferent ce alegi.
Criteriile generale de alegere între unelte le-am detaliat în cum alegi un tool AI potrivit.
Părerea mea
Partea care merită reținută nu e că transcrierea s-a ieftinit. E că, pentru română, cel mai bun rezultat publicat vine de la trei oameni dintr-un laborator din București, cu un model de paisprezece ori mai mic decât al americanilor, finanțat din bani publici și dat gratis.
Asta ar trebui să-ți spună ceva despre unde e de fapt valoarea. Nu în modelul cel mai mare, ci în datele potrivite pentru problema ta. Iar pentru limba română, datele alea le are cineva de aici sau nu le are nimeni.
Dacă ai un flux serios de transcriere în română, testează local înainte să plătești un API. S-ar putea să descoperi că lucrul cel mai bun e și cel gratuit.
Întrebări frecvente
Ce program de transcriere audio in text merge pe română?
Pentru română, un model mic antrenat local bate modelele mari generaliste. Detaliile și cifrele comparative sunt mai sus. Pentru volume mari, prețul prin API a coborât la zece cenți pe oră de audio.
Cât costă transcriere fisier audio in text?
Prin API, de ordinul cenților pe oră de înregistrare. Aplicațiile cu abonament lunar se justifică doar peste câteva zeci de ore pe lună; sub asta, plata la consum e mai ieftină.
Merge transcriere voce in text fără internet?
Da, modelele mici rulează local pe un laptop obișnuit. Pierzi câteva procente de acuratețe față de variantele din cloud, dar înregistrarea nu părăsește calculatorul — ceea ce contează dacă transcrii ședințe sau consultații.